在 Imagination,我们正在努力让日常设备也能加速运行 LLM。在这篇关于 LLM 性能与加速的新两部分系列文章的第一篇中,我们介绍两个关键性能指标:首次输出时间(Time to First Token,TTFT)和 token 间延迟(Inter-Token Latency,ITL)。下一篇我们将分享我们为将高效的 Llama.cpp 推理带到 Imagination GPU 上所做的工作。
如果你见过 Google 的“AI Overview”或 Word 的下一词预测,那就是 LLM 在发挥作用。它们建立在 transformer 网络之上,利用 attention 机制聚焦输入中最相关的部分——类似于你观看一场足球比赛时,会本能地跟着拿球的球员,而不是场上的另外 21 名球员。LLM 的神奇之处在于,它们通过建模概率,捕捉到了一些人类思维过程,因此在各种应用中都非常有用。
挑战在于,这一切都需要大量计算。LLM 依赖大规模矩阵运算,这类运算虽然要求高,但并行性也很强:换句话说,非常适合 GPU。
这也是为什么包括基于 PowerVR 架构的 Imagination GPU 在内的产品,在让这些模型快速高效运行方面扮演关键角色,尤其是在功耗和性能都至关重要的移动端和边缘设备上。
加速 LLM 推理
大语言模型(LLM)通过使用前文的上下文窗口来生成文本,并预测序列中的下一个 token。当提示词首次提交时,模型必须处理上下文窗口中的所有 token,这可能非常耗费计算资源。模型生成的每个新 token 都会被追加到前面的 token 后面:这就是自回归模型。
一种朴素的推理方式,是在每一步都把整个提示词,包括新生成的 token,一并重新处理:
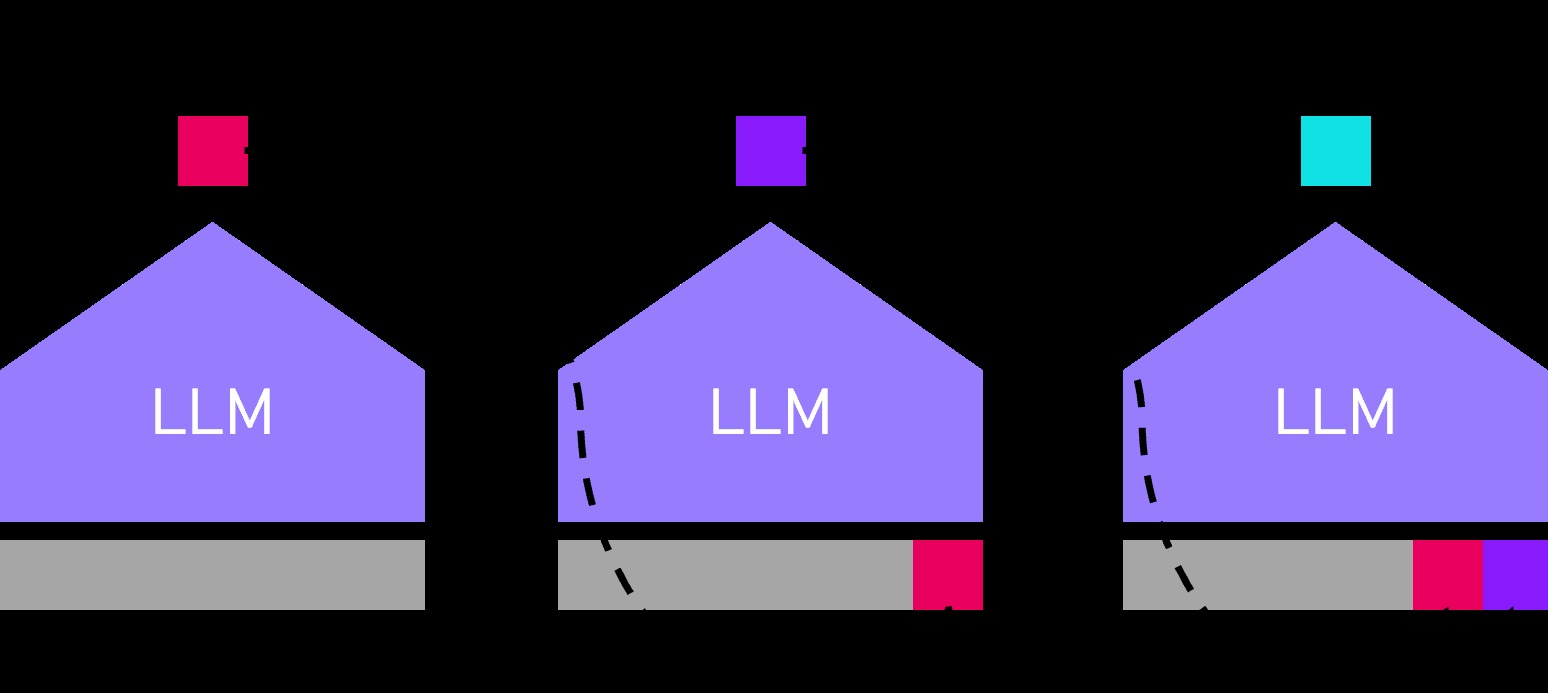
这样一来,随着每生成一个新 token,推理速度都会越来越慢。
为了提高效率,框架通常会使用 KV 缓存,它会存储此前已处理 token 的中间结果。这种方法避免了重复计算,并显著加速推理,使 LLM 即便在性能一般的硬件上也能实际可用。它还会让随着新 token 生成,执行时间大致保持恒定。
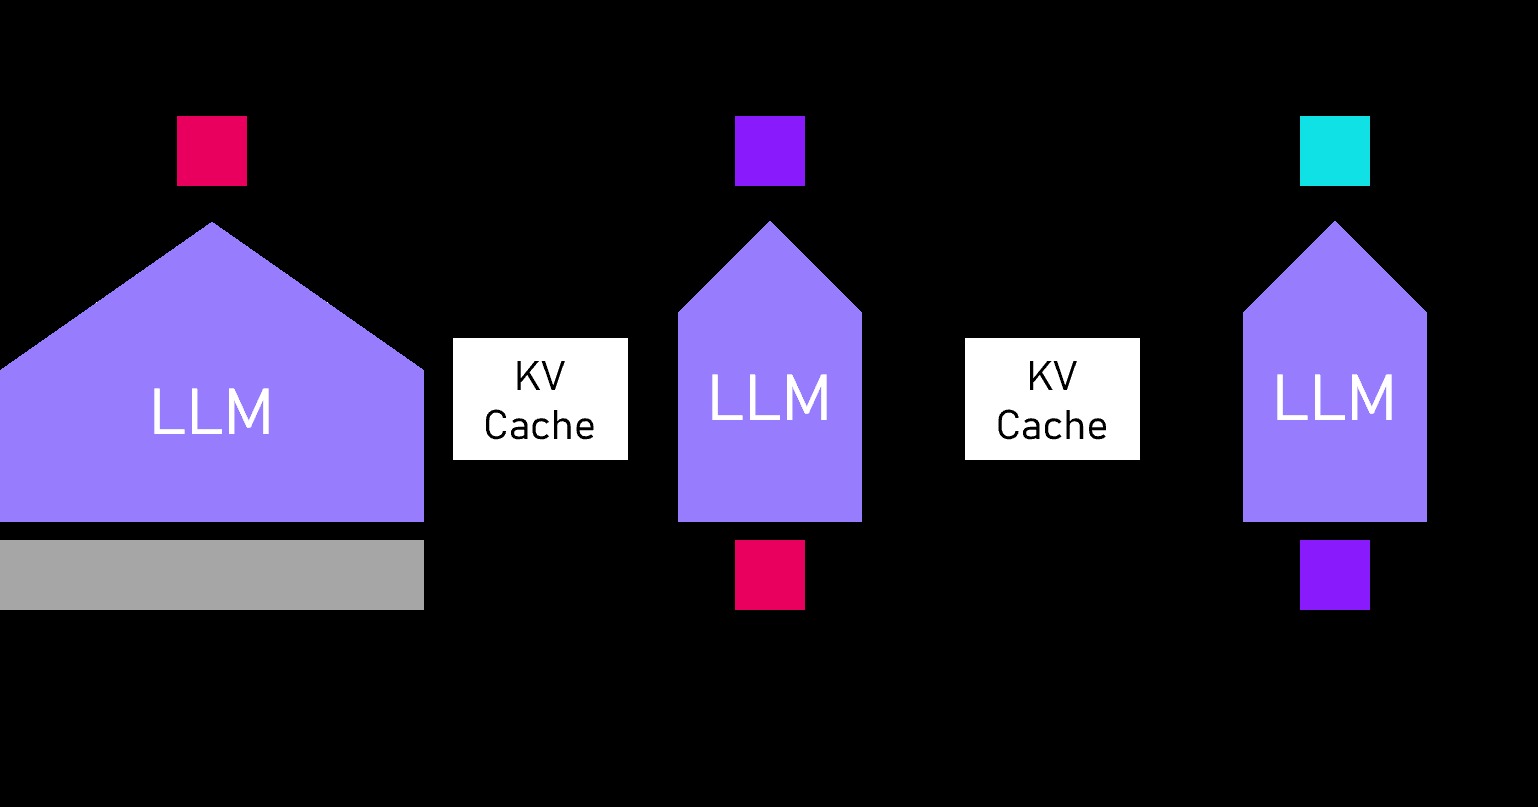
由于 KV 缓存的存在,LLM 通常以两种不同模式运行:
Prefill 模式:模型处理完整的 token 序列并初始化缓存。这个阶段涉及大规模矩阵乘矩阵运算,通常受 GPU 计算吞吐限制。
Decode 模式:复用缓存结果来生成后续 token。由于跳过了前面的计算,这一模式要快得多。它依赖矩阵乘向量运算,通常受 GPU 内存带宽限制,因为需要流式读取权重和激活值。
这两种模式在用户体验以及对硬件资源的压力上都不同,因此每种模式都应使用各自的性能指标来衡量。
LLM 性能指标
因此,在讨论 LLM 的部署性能时,通常会提到两个指标:
首次输出时间
TTFT 指的是 LLM 生成第一个输出 token 所需的时间,此时模型必须已经处理完用户输入的全部提示词(即完成 prefill 阶段)。
首次输出时间通常在汽车场景或交互式应用中非常重要;人类习惯于以自己说话的速度被“听见”,如果数字助手或应用的响应速度没有达到人类对话的节奏,那么用户体验就会开始下降。
按今天的标准来看,如果你在 Google 里输入一个问题,却要等几十秒才弹出答案,也会相当令人沮丧(当然,有些人还记得从磁带上加载电脑游戏要等多久……)。
因此,无论是在数据中心还是边缘端,GPU 厂商面临的挑战都是:即便在功耗受限或连接条件较差的场景下,也要为用户提供快速的首次响应。
为了更具体地说明这一点,以 LLM 能够为输入查询生成第一个 token 为例(例如 Llama-3.2-3b 模型),它需要处理下方大量的矩阵乘矩阵运算规模,其中 N 参数是用户输入 token 的数量;在这个例子中,用户提示词是“Building a website can be done in 10 simple steps:”,因此 N 为 13。
表 1:LLAMA-3.2-3B 模型的典型 GEMM M、K 和 N 维度。
llama.cpp 中的矩阵乘矩阵运算如下:
C T = A * B T
这意味着 C(N×M)由 A(M×K)乘以 B(N×K)计算得出。还需要注意的是,C 和 B 都是转置矩阵,这意味着与原始矩阵相比,转置矩阵的数值会沿对角线交换位置。
LLM 的 prefill 阶段需要执行一些相当大的矩阵乘矩阵运算,这正是 PowerVR GPU 可以加速的地方!这些矩阵乘法彼此独立,且只需要极少交互,这与 GPU 的 SIMT 架构高度并行的特性非常契合。
在模型能够生成第一个输出 token 之前,上述矩阵乘矩阵运算通常需要执行多个迭代,而处理这些运算所花的时间,直接决定了用户需要等待多久模型才开始输出。
token 间延迟
衡量 LLM 性能的第二个指标是“token 间延迟”,顾名思义,它指的是模型生成单个新 token 所需的时间,也就是模型逐个 token 生成输出时,token 与 token 之间的时间间隔。
这一过程与评估用户提示词的过程略有不同,因为它涉及的是矩阵乘向量运算,而不是矩阵乘矩阵运算;并且由于前文提到的 K-V 缓存技术,这一阶段的计算强度要低得多。
生成阶段(或 decode 阶段)的数学运算是一系列矩阵乘向量运算,其中 N(在 M、K、N 中)始终等于 1,而最后生成的 token 会作为单个向量输入到每一层下一组矩阵乘向量运算中。
在 GPU 上加速矩阵乘向量运算是可行的,但由于这类运算的计算密度较低,当把它们卸载到 GPU 时,往往会受到内存带宽限制。因此,LLM 的 decode 阶段也可以在 CPU 上完成,因为 CPU 的内存带宽可能没有那么受限。一般认为,要在 LLM 计算的这一(decode)阶段通过 GPU 增加价值更难,不过,如果部署 SoC 的主 CPU 负载很高,将 decode 阶段卸载到 GPU 仍然会很有用。
表 2:LLAMA-3.2-3B 模型的典型 GEMV 计算。
结语
以上就是这篇两部分博客的第一部分,我们探讨了如何在基于边缘设备、例如 PowerVR GPU 上加速 LLM 推理。我们介绍了首次输出时间和 token 间延迟的概念,以及它们如何对应于 LLM 计算的两个主要阶段。
在第二部分中,我们将看看 Imagination 为支持 PowerVR GPU 架构而对 Llama.cpp 应用所做的代码修改,包括通过 Vulkan 以及默认的 OpenCL 实现。最后,我们还将分析我们自己优化过的 OpenCL 内核,这些内核专门针对在使用 F16 和量化权重格式时,释放 PowerVR GPU 在矩阵乘矩阵和矩阵乘向量运算中的高利用率。
Alex Pim