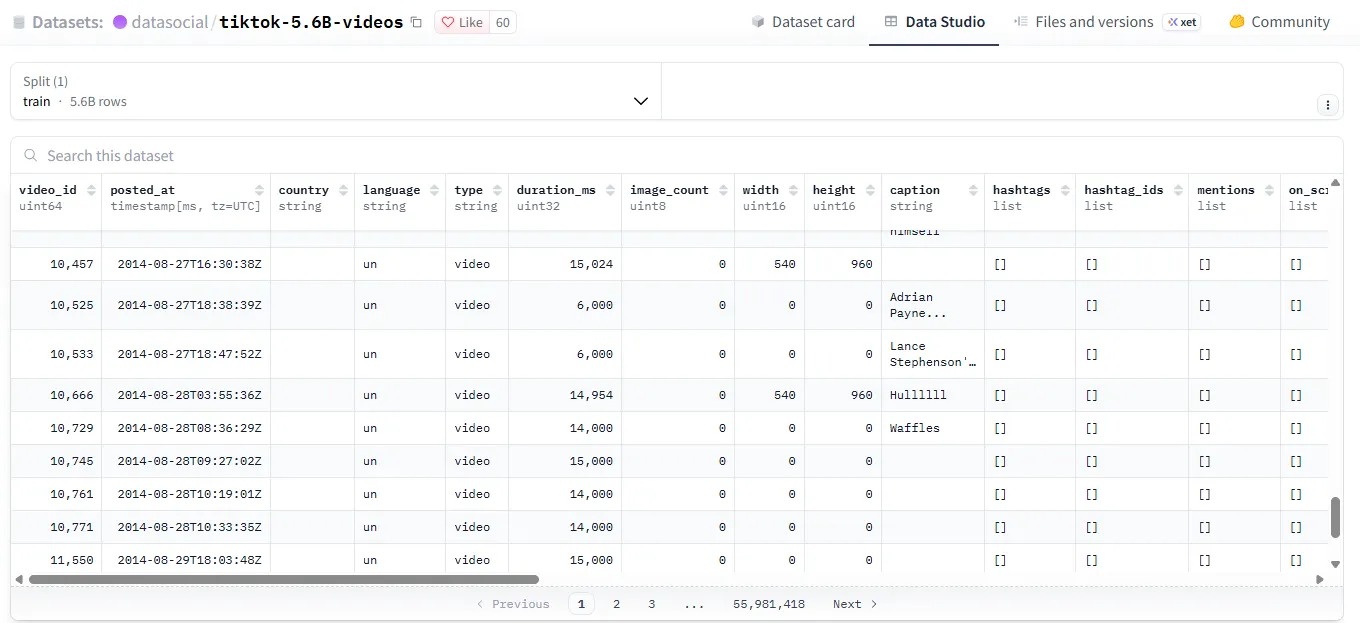
一名使用 hashfunction 名称的开发者在开源 AI 仓库 Hugging Face 上发布了约 56 亿条 TikTok 公共视频的元数据,可免费下载。该数据集以 datasocial 账户发布,时间范围从 2014 年 7 月延续到 2026 年 10 月。
这只是元数据,不是视频本身。每一行都包含标题、标签、音频 ID、屏幕文字、TikTok Shop 商品和卖家 ID,以及浏览量、点赞数、评论数、分享数、收藏数和下载数等统计信息。整个数据集由按月划分的 Parquet 文件组成,总计 460GB。
其中一些字段来自 TikTok 自身的标记,例如视频是否被标记为 AI 生成,以及 TikTok 是否将其排除在“For You”推荐页之外。对于较早的视频,AI 标记往往为空,因为这些内容来自存档。
为什么会有人在意?因为 AI 开发者想要这类数据,而 TikTok 让获取它变得很困难。数十亿条帖子的标题、标签、音频 ID 和互动数据,是训练模型的原始材料,可用于预测什么内容会爆红、什么内容会在 TikTok Shop 上卖得好、哪些词语和短语更能吸引点击,以及帮助语言模型学习人们如何在短视频中写作。
TikTok 获取这些数据的官方途径要窄得多。其 Research Tools 向符合条件的研究人员开放,适用于美国、欧洲经济区、英国、加拿大和瑞士等地区的学术机构,以及欧盟内的一些非营利组织,但需要提交申请并获得批准。
平台并不允许广泛抓取数据。TikTok 美国服务条款第 3.4 条规定,除非 TikTok 书面批准,否则不得使用自动化软件从平台提取数据。
免费版本也相当于一个引流入口。该数据集采用 CC BY-NC 4.0 许可,页面说明其可用于研究和个人用途。商业用途、创作者资料以及每日更新则被导向 datasocial.ai,而抓取器的源代码则单独出售。
围绕抓取数据的争议已经进入法庭。Reddit 于 2025 年 10 月起诉 Perplexity 以及三家数据抓取公司,指控它们以“工业规模”方案收集其内容用于 AI 训练。根据 Law360 报道,今年 7 月,一名联邦法官基本拒绝驳回该案。
仍然存续的指控包括 DMCA 相关指控,即 SerpApi 绕过了 Google 的反机器人保护。TikTok 并非该案当事方,而且该案涉及的是通过 Google 搜索结果进行抓取,而不是通过私有移动 API。
就数据本身而言,这些行包含标题、使用的音乐以及不同的勾选项。文中提到,虽然没有创作者账号列,但数据展示了大量信息,包括标题、标签、视频中提到的人等。不过,Datasocial 中实际上可以看到用户 ID。
这批数据并不是唯一的同类产品。Hugging Face 上也有另一份 45 亿条视频的数据集副本,同样被描述为来自 TikTok 的移动 API。
该数据可供非商业用途免费使用。收集这些数据的代码售价为 1,699 美元。