IT之家 11 月 6 日消息,淘宝旗下 MNN 团队今日发布了 MNN-Pocket-0.3B 模型,面向手机应用的任务需求与资源预算,在有限算力、内存和能耗下,兼顾任务能力、响应速度与持续运行体验。
围绕淘宝等综合型手机应用,团队将“手机应用原生大模型”落实为四个维度的设计目标:
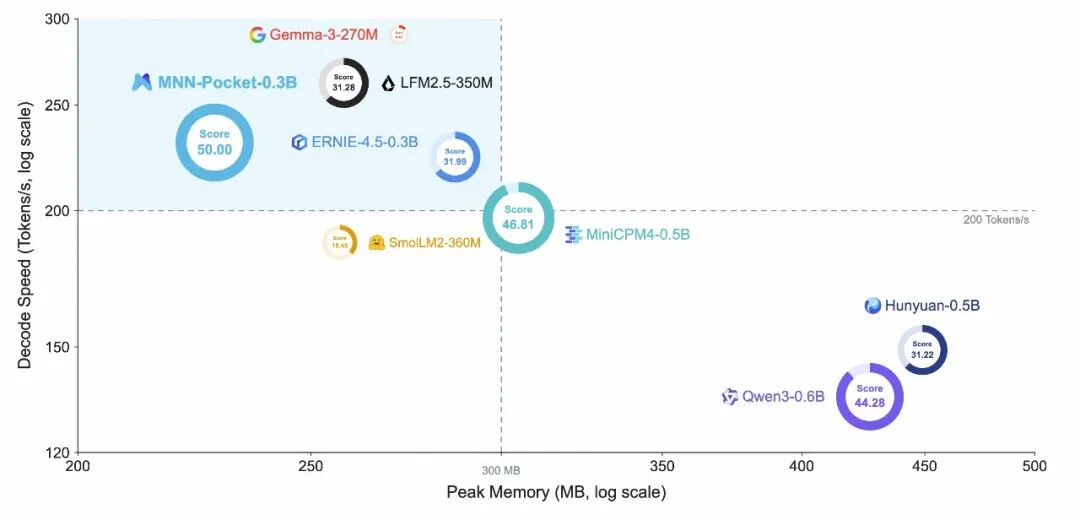
- 速度上,在指定设备与上下文配置下,解码吞吐超过 200 token/s。这一目标参考高速云端模型服务的生成吞吐,力求在本地提供流畅的生成体验。
- 内存上,在指定测试条件下,峰值内存低于 300MB。即使手机拥有 8~16GB 内存,也需要由系统与多个应用共享。以约 500MB 的模型模块预算为例,将推理峰值控制在 300MB 以下,可以为上下文增长和集成开销保留余量。
- 功耗上,在典型推理负载(输入 512~1024 token、输出 128 token)下,单次推理增量能耗目标不超过参考手机电池能量的万分之一,即 100 次推理耗能不超过电池总量的 1%,控制高频调用的续航开销。
- 能力上,以在指定业务场景上达到 8B 级模型的效果为目标,兼顾中英文理解、世界知识与数学、代码推理能力,重点强化指令遵循,并为长上下文与多步骤任务保留扩展空间。
MNN 团队从零设计并训练了这个约 3 亿参数、重点支持中文与英文的轻量语言模型,将模型结构、词表、训练数据、预训练与后训练方法,以及量化和推理引擎纳入协同优化,为淘宝业务与开源社区开发者提供一个具备任务理解能力、响应迅速、易于适配和集成的模型底座。
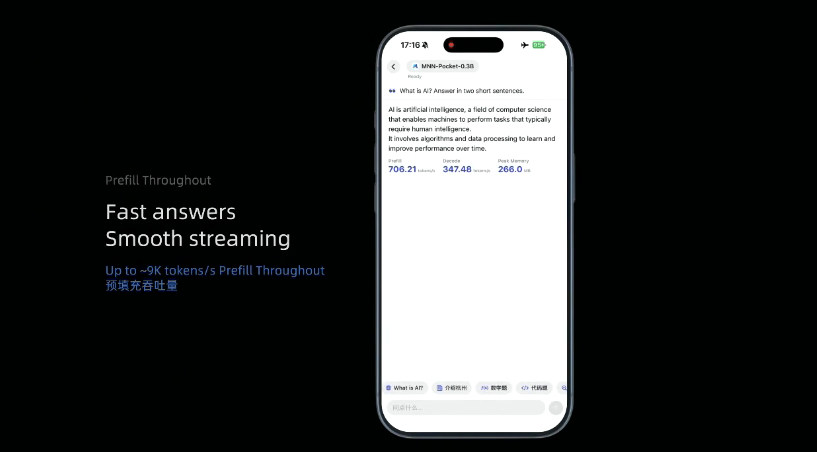
MNN-Pocket-0.3B 在苹果 iPhone 18 Pro 上的真机表现实测中,模型通过 MNN 推理引擎完全离线运行,平均解码(Decode)速度约为 350 token/s。
MNN-Pocket-0.3B 的 INT4 MNN 部署文件体积仅为 173MB,包含模型权重、分词器、计算图和推理配置。
在 iPad Pro M5、Metal 后端、512 token 测试配置下,模型加载与推理期间的峰值 Metal 驻留内存相对加载前基线增加 228MB。
同一测试中,Qwen3-0.6B 的部署文件体积为 340MB,峰值内存增量为 427MB。相比之下,MNN-Pocket-0.3B 的部署体积减少约 49%,峰值内存增量减少约 47%。
对于手机应用原生大模型,较小的部署体积能够降低模型下载与更新成本,较低的运行内存则为页面、图片、视频等业务模块保留更多空间,降低应用集成的资源负担。
团队在苹果与 Android 设备上,使用 Metal、OpenCL 和 CPU 后端评估推理吞吐。测试采用 MNN 3.6.2、INT4 量化及统一运行设置,每组配置预热一次、测量五次,取吞吐中位数,Prefill 与 Decode 分别测量。
在 iPad Pro M5/Metal、512 token 测试配置下,MNN-Pocket-0.3B 的 Prefill 吞吐达到 8,721 token/s,Decode 吞吐达到 466 token/s,约为同条件下 Qwen3-0.6B(286 token/s)的 1.63 倍。在 Snapdragon 8 Gen 5 的 CPU 后端,Decode 吞吐达到 251 token/s。
面向手机应用原生大模型,团队将峰值内存低于 300MB、解码吞吐高于 200 token/s 作为架构选型目标,在资源预算内尽可能保留模型容量。围绕这一目标,团队构建了覆盖约 50M 至 1.3B 参数的稠密(Dense)模型配置,在 iPad Pro M5、统一推理设置下进行测试。约 300M 是该组实验中同时满足两项约束的最大候选规模。
确定规模后,团队进一步在相近参数预算内,联合调整模型深度、隐藏层宽度、前馈网络与注意力配置。从 16 层增加到 28 层带来了能力提升;继续增加到 36 层,评测均分没有进一步提高,解码吞吐却从 355 token/s 降至 323 token/s。这里的吞吐用于架构选型对比,与前述最终部署版本的测试配置不同。
最终,MNN-Pocket-0.3B 采用 28 层结构,结合分组查询注意力(GQA)等配置,在模型能力、运行内存与推理效率之间取得平衡。
面向中文互联网手机应用,MNN-Pocket-0.3B 将中文与英文作为重点支持语言,降低对其他语言分词效率的优先级。基于 Qwen3 分词器,团队将词表从约 151K 精简至 64K,词条数量缩减约 57%,减少词嵌入与输出层的参数和存储需求,并降低逐 token 生成时的输出投影开销。
在能耗方面,团队还在一加 13(骁龙 8 至尊版)上,使用 MNN 对 MNN-Pocket-0.3B 的 4-bit 模型进行了功耗测试。在 CPU4 线程、输入 1024 和输出 128 基准负载下,通过采集电池电流与电压,并扣除闲置基准耗电,三轮测试折算的平均增量能耗约为 2.7J/轮。以该手机电池容量 6000mAh 计算,执行 100 次同等负载任务累计增量能耗约占电池总电量的 0.3%。
模型能力方面,在技术报告采用的评测设置下,MNN-Pocket-0.3B 的英文 IFEval 得分为 73.20,团队构建的中文指令遵循 IFEval-zh 得分为 74.59,在所比较模型中均取得最高分。
在覆盖中英文知识、推理、数学、代码与指令遵循的 11 项评测中,模型平均得分达到 50.00,高于报告列出的同规模模型,以及 MiniCPM4-0.5B、Qwen3-0.6B 等更大规模的对比模型。其中,中文数学 MGSM-zh 得分为 51.20,代码生成 HumanEval 得分为 53.66。
手机应用原生大模型的价值,还需要通过任务适配与应用集成来验证。为此,MNN-Pocket-0.3B 提供了从预训练、后训练到端侧部署的多个版本,让研究者与开发者能够选择合适的起点,继续训练、评测和构建应用。
从研究到部署,MNN 团队开源不同阶段的模型入口:
IT之家附开源地址如下:
https://github.com/alibaba/mnn