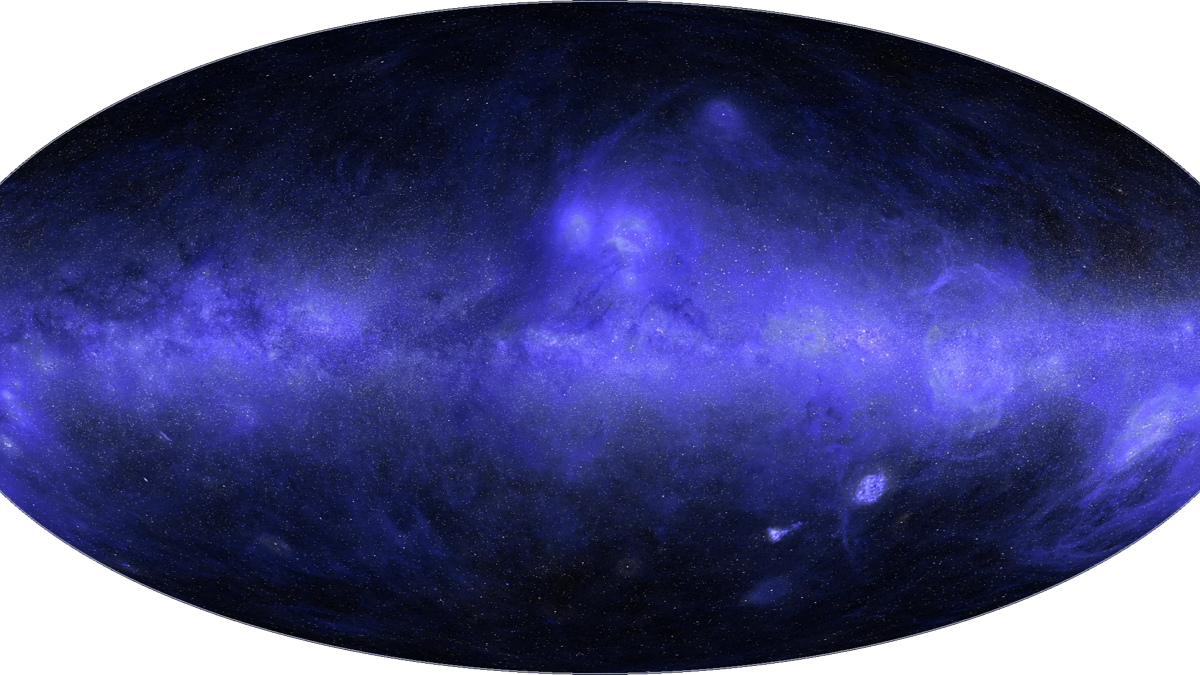


如果把夜空切换到紫外波段,银河系的轮廓会和肉眼熟悉的星空大不相同。尘埃在年轻恒星的照射下发亮,恒星爆发留下巨大的环状结构,星系平面之外还有细丝般的弥散物质。长期以来,研究者却很难向学生展示一张完整的紫外全天图:不是因为没有人想做,而是已有太空观测本身存在大片空白,来自不同仪器的数据也不能简单拼接。10月8日,Anthropic公布了约翰斯·霍普金斯大学天体物理学家Brice Ménard使用Claude Science整理观测、校准数据并补全缺口的过程。成果已经可以交互查看,但“完整”说的是地图覆盖范围,不意味着每个位置都由望远镜直接测得。
这一点恰恰是报道的关键。Anthropic说明,图中大约三分之一的天空,包括银河系平面的大部分位置,是根据已有紫外观测和其他波段资料推算出来的。项目为每个像素提供“实测”或“预测”的标记与不确定度估计。把模型填补的区域写成新发现的太空观测,会抹去科学工作最重要的证据边界;把它简单称作AI“画了一张星空图”,又会忽略清洗、交叉校准和验证这些真正费力的步骤。
难点并非作图,而是把不同来源的数据放在同一尺度
地球大气的臭氧层会吸收紫外光,地面望远镜无法像拍可见光那样完成全天紫外扫描。NASA的GALEX任务在2003年至2013年间获得了约3.8万次观测,覆盖约三分之二天空;它有意避开可能损伤探测器的明亮恒星区域,其中就包括星体密集的银河系盘面。NASA的Swift、韩国FIMS/SPEAR等任务提供额外资料,仍不足以让每一块天区都有直接测量。这里的空白是仪器观测策略和历史数据覆盖造成的,不是网页加载失败或普通图片缺像素。
研究团队先让Claude寻找公开紫外巡天资料,再处理同一巡天内部的差异。不同时间和视场拍摄的图像,其背景亮度、恒星眩光与仪器响应未必一致;把它们直接贴在一起,接缝会成为假信号。来自不同望远镜的资料还需要统一坐标、分辨率和光度尺度。Anthropic描述,多个代理并行处理不同天区,但研究者持续给出高层判断和复查结果。这不是一次提问后由模型凭空生成科学结论,而是一个以公开观测为输入、以重复校验为条件的数据工程流程。
真正缺乏紫外实测的区域,项目采用类似图像修补的统计方法,并引入可见光、红外和射电波段的信息。模型在已测得紫外光的天空区域学习其他波段与紫外亮度之间的关系,再将关系用于未观测区。为了检验推断能力,研究者故意遮住已有紫外数据的一部分,让模型在看不到真值的条件下重建。官方文章给出的结果是,数轮改进后,被遮挡区的估计与实际紫外测量相差约10%。这只是该验证设置中的结果,不能自动推广为每一片未观测天空都具有同样误差。
地图还叠加了利用欧洲航天局Gaia可见光观测推断的超过一亿颗恒星的紫外贡献。这样得到的成品同时包含望远镜实测、统计填补和恒星模型推断。读图时,如果不知道每层从何而来,就可能把算法推断误认作新观测;反过来,清楚保留来源标签,就能把地图作为教学和进一步研究的入口。完整的可视化并不消除不确定性,恰好使不确定性可以被逐点查看。
人工复查发现圆形伪影,说明代理的“自检通过”不是终点
Anthropic披露了一个很有代表性的返工细节。Ménard在检查暗弱天区时,发现地图上有浅浅的圆盘轮廓,正好对应GALEX单次观测的视场。问题来自地球大气残余紫外辉光:每次观测都带有略不均匀的背景,如果没被充分扣除,拼接后的区域会出现一圈圈不应存在的结构。Claude最初把这种风险列为已知问题,地图却仍通过了另外两轮代理审查。研究者指出异常后,代理才回头分析成因、重新处理约3.8万次观测,最终消除可见的圆盘伪影。
这个过程比“AI几小时做完人类数周工作”的口号更有价值。能调用工具、并行处理、长时间运行的系统确实可以降低某些历史数据整理项目的门槛;但它也会把错误规模化。若整套流程共享错误的背景校准假设,多个代理检查同一结果并不等于独立验证。科学工作需要保留原始资料、处理步骤、测试集和可追溯的人工判断,让别人能够知道某个漂亮纹理到底来自天空还是来自仪器。
这张紫外全天图的现实意义主要是教育与研究资源,而不是宣布发现了新的天体或彻底解决紫外观测不足。官方文章谈到,弥散尘埃、年轻恒星附近的亮云,以及大质量恒星爆发留下的结构,在新图上更便于整体观看。未来若有新的太空观测进入这些空白区域,预测层应该接受实测检验并被更新。对于正在把AI用于科研的团队,这则案例提供了一套更稳妥的衡量标准:看它是否找到可信数据、能否说明哪些部分是估计、是否留有误差标记,以及研究者能否在发现伪影时把整条处理链追溯和修正。地图的边界写得越清楚,它作为科学工具才越有用。