

微软10月12日披露了新一代Azure Maia 300的部署计划。标题里最吸引人的词是“多吉瓦”,但时间线更重要:Maia 300的生产部署预计从2027年开始,随后才计划走向多吉瓦规模。现在已经进入生产环境的是上一代Maia 200,它用于Copilot相关负载;微软还表示,GitHub Copilot和Foundry的相关使用会在今年晚些时候跟进。把这些阶段混在一起,就会把一项未来扩容计划误写成今天已经上线的机房事实。
对微软而言,Maia系列不是一颗用来展示技术肌肉的孤立芯片,而是Azure数据中心的整体设计问题。生成式AI推理增长很快,企业最终支付的不是晶体管数量,而是每次输出所消耗的电力、机架空间、网络和运维成本。供应商可以继续采购外部加速器,同时开发自有芯片,以便为不同负载配出更合适的系统。Maia 300的意义,必须放在这个多来源算力策略里看。
从单颗芯片到整柜效率,微软真正比较的是什么
微软给出的参数包括HBM4内存带宽每秒18TB、芯片功率950瓦,以及每柜96个加速器、约167千瓦的系统配置。高带宽决定大模型推理时数据能否及时送到计算单元;功率与机柜密度则决定数据中心如何供电、散热和布线。单看一颗芯片的峰值性能很容易,困难的是让整柜设备在持续负载下保持利用率,并让故障、网络拥塞和维修不吞噬理论收益。
官方称,相比其所定义的领先GPU系统,Maia 300每兆瓦可产生的token数量有望提高40%;与Maia 200相比,机柜吞吐量目标提高七倍。这里至少有两层限定不能省略:前一个是微软对未来系统的性能预期,且比较基线由公司给出;后一个是跨代、跨机柜的系统层级比较,不是单颗芯片速度直接增加七倍。没有公开完整测试条件、真实工作负载组合和第三方复测时,这些数字更适合作为设计目标,而非已经实现的行业普适结论。
“每兆瓦token”这个口径为何重要?过去的芯片发布常按每秒浮点运算或单卡跑分争胜,如今云厂商要向企业提供持续可用的推理服务。机房电力配额、接入周期与峰谷负载共同限制收入上限。即使芯片本身便宜,若需要昂贵的网络、存储、液冷或频繁停机,单位输出的总成本也未必更低。反过来,一套专门为固定模型和调度体系设计的系统,可能在某些工作负载上胜出,却未必适合所有开发者的训练与实验需求。
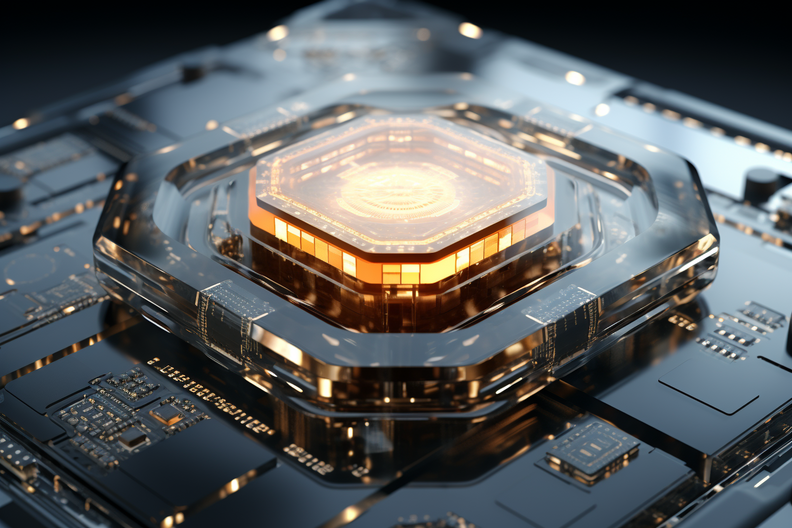
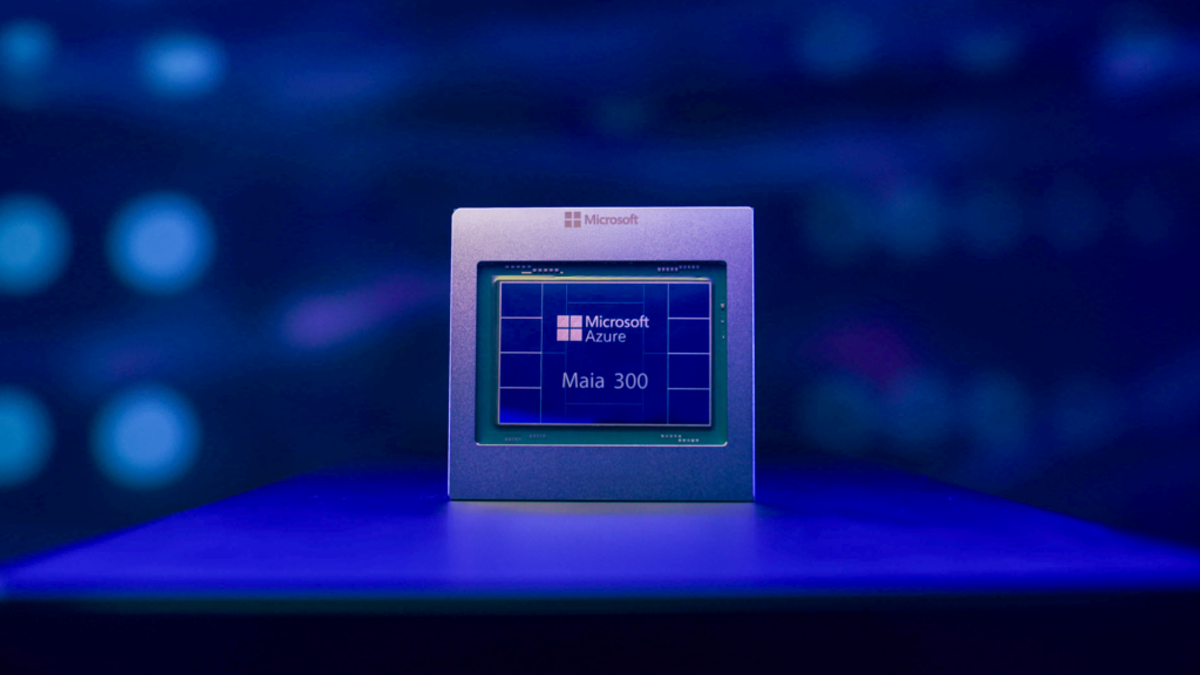
微软展示的实物芯片图片说明设计已走到硬件阶段,却不能证明大规模部署已经完成。半导体产品从样片到可靠生产,还要经历软件栈适配、良率、散热、电源和供应链验证。2027年开始部署与随后的多吉瓦扩容之间,也可能隔着多个数据中心建设周期。报道时把计划节点写清楚,既能保留这一投资的分量,也避免把路线图当成已经交付的算力。
自研芯片不是“抛弃GPU”,而是重新分配选择权
Maia 300发布后,一个常见的误读是微软要立刻从外部GPU供应商切走。现实更可能是并行:训练、前沿实验、通用云实例和大规模推理的需求差别很大,不同硬件各有优势。Azure既要承接客户已经建立在GPU工具链上的应用,也希望把稳定、高量的自有产品负载迁向更合算的系统。自研芯片让微软有更多议价与排程空间,但只有软件兼容性和实际运维数据跟上,这种选择权才会转化成财务收益。
对企业采购者,现在需要问的不是“Maia 300是否比某张GPU快”,而是可用区域、服务等级、模型支持、计费口径和迁移成本。Maia 200已经在Copilot环境运行,可以为技术路线提供真实运维反馈;Maia 300尚未进入公告所说的生产阶段,客户今天不能按照未来容量安排上线日期。若供应商未来报告更低的单位推理成本,还应核对它是否包含网络、电力、折旧和故障冗余,而非只比较芯片功耗。
微软选择此时公布计划,也反映AI基础设施竞争的方向在变化。行业不只争“谁先拿到更多芯片”,还在争谁能把芯片、机柜、网络、模型和应用调度成经济上可持续的服务。Maia 300的参数足够明确,值得持续追踪;但真正的成绩单要等2027年生产部署开始,并观察在实际负载和透明口径下能否兑现每兆瓦输出。现阶段最准确的判断是:微软公布了一条有量化目标的系统路线,并非宣布多吉瓦Maia 300集群已经运行。
还有一项容易被忽略的检验是软件迁移。芯片换代不等于模型自动跑得更快,编译器、算子库、监控工具和故障切换都要适配。对一家全球云厂商而言,若只能让自家少数模型享受收益,规模效应会受限;若未来能让更多客户以稳定接口获得相近效率,硬件投入的价值才更清楚。微软现在披露的是硬件路线与内部负载规划,尚未给出让普通Azure客户直接选择Maia 300实例的完整产品清单。报道和采购决策都应保留这层区别。