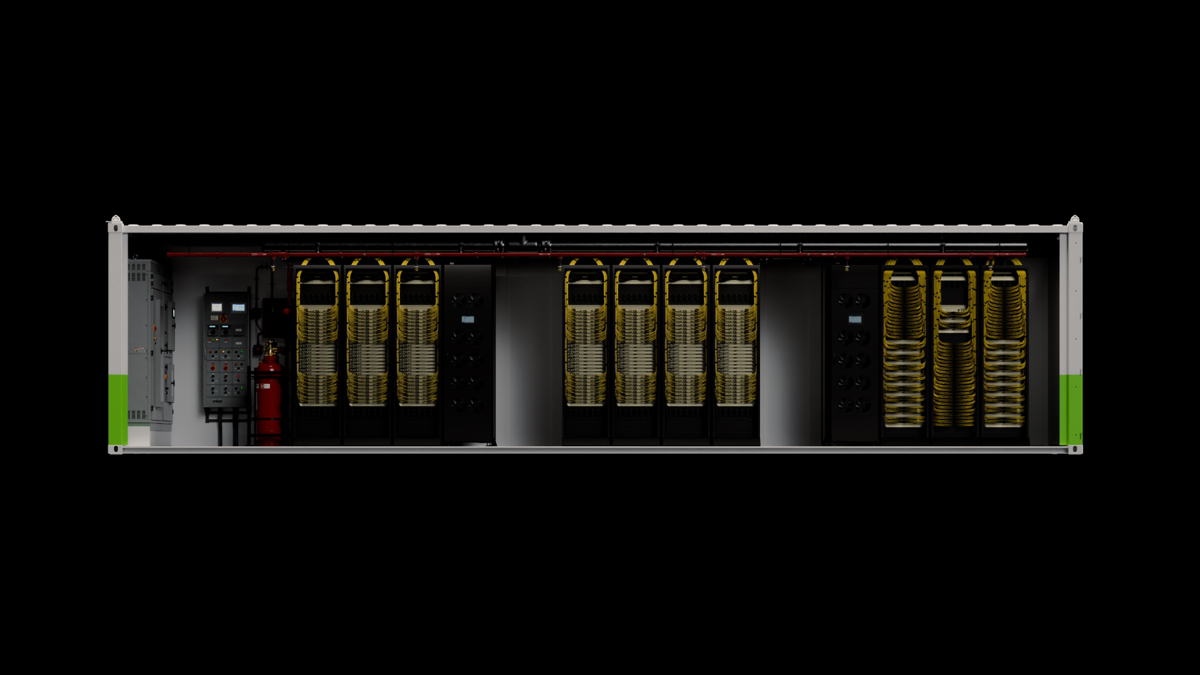


英伟达在10月21日的GTC Berlin发布DSX POD,试图改变大型AI算力项目漫长而分散的建设顺序。按照公司公布的方案,这是一套面向Vera Rubin系统的参考设计:合作伙伴在工厂中完成模块化容器、计算、供电、冷却和网络的集成与验证,再把已调试的单元运往准备好的场地。英伟达给出的对比是,若场地已具备条件,部署所需时间有望从约六个月缩短至最快14天。这里有两个不能省略的限定词:这是其提出的设计与目标,不是所有客户已经实现的交付纪录;“14天”也不包含选址、许可、接电和其他前期工程。
过去谈AI工厂,注意力多落在芯片数量与理论性能上。真正决定项目何时创造收入的,却常是机柜进场之后的一串交接:供电容量是否落实,液冷接口是否匹配,网络拓扑与管理软件能否在现场同时工作,验收时能否稳定运行真实模型。任何一个环节延误,都可能让已经采购的昂贵设备等待场地。DSX POD的新闻价值正在这里:英伟达希望把此前留到现场解决的集成问题,尽量提前到可控的工厂环境解决。
从现场拼装到工厂预验收,缩短的是哪段时间
英伟达将DSX POD定义为完整AI工厂的模块化参考设计,而非单独售卖的某台服务器。合作伙伴可按其规定的计算、存储、网络、电力与散热接口,把若干容器化单元预先组装、连通和测试。运抵准备好的场地后,项目方仍须完成基础设施连接、最终调试和运营验收。这个顺序与传统数据中心现场逐项安装不同,但它并没有消除工程依赖,更没有让电网接入凭空变快。
发布材料把“time to first token”作为衡量经济性的节点:只有模型开始为生产负载提供推理服务,投入的资产才可能产生对应收入。对购买方而言,这个指标比发布会上展示的峰值算力更贴近现金流;对建设方而言,它意味着预制单元的价值必须以实际可用的服务能力证明。若现场仍缺电、缺水或许可未完成,所谓更快的交付就无法自动转化为更早的收入。因此,读者不宜把英伟达的最快周期当作普遍施工工期。
公司列出的合作阵容横跨计算设备商、机柜与基础设施供应商,包括Dell、HPE、Lenovo、Schneider Electric和Vertiv等。名单说明其希望用统一的参考设计让不同厂商协作,却不等于每家合作伙伴已经交付同一规格的商业项目。英伟达说这些合作伙伴正为2027年初在全球交付模块化AI工厂做准备;时间表属于前瞻性安排,后续还要看实际订单、生产能力和场地条件。
这也解释了为何“集装箱化”并非新闻的全部。若仅把设备放入箱体,却仍需在现场反复排查互联、热管理和软件配置,效率改善可能有限。参考设计真正试图出售的是接口确定性和可重复的验证流程:同一类问题在工厂解决一次,再尽量复制到多个场地。它或许能降低异地交付的协调成本,但也会把需求集中到标准化组件的供应、厂商间兼容与质量控制上。
投资人和客户接下来应核对哪些实绩
第一项是实际部署口径。英伟达目前给出的“从六个月到最快14天”是准备好场地之后的部署比较,不能拿来与一座AI园区从拿地到运行的总工期直接相比。未来若有案例公布,须同时披露场地先决条件、模块规模、开始计算和正式生产的定义,才知道两个时间数字是否可比。预制率越高、现场要求越明确,所节省的环节才越容易量化。
第二项是系统边界。Vera Rubin是下一代平台,DSX POD所对应的是一整套配套工程,而非对现有任何GPU机房的通用改装承诺。客户的模型类型、功率密度、可用性标准和网络架构不同,单一交付周期难以覆盖。大型训练集群与面向低时延推理的区域节点,可能需要截然不同的冗余和互联安排。方案是否能适配多种场景,要以伙伴的产品规格和真实验收报告为准。
第三项是经济账。建设更快可能减少设备闲置,但预先采购的模块、运输、保险、备用容量与维护同样有成本。项目方需要比较全生命周期成本,而不是只计算安装天数。倘若算力需求、模型价格或利用率变化,提早开机也不保证回报率。英伟达强调“更早生成生产token”的逻辑成立的前提,是上线后确有稳定需求且能以合适价格售出服务。
最后是供应链协调。参考设计与众多伙伴共同推进,有利于形成可复制的交付方式,也增加了多方责任划分的复杂度。出现现场性能不达标时,究竟由计算设备、冷却、供电、网络还是集成商负责,合同和验收标准必须提前写清。DSX POD因此是一个值得关注的工程组织变化,却还不是全球AI工厂部署速度已经整体跃迁的证据。今后最有说服力的新闻,不会是又一张模块示意图,而是经客户确认、具有完整边界条件的交付与运行数据。