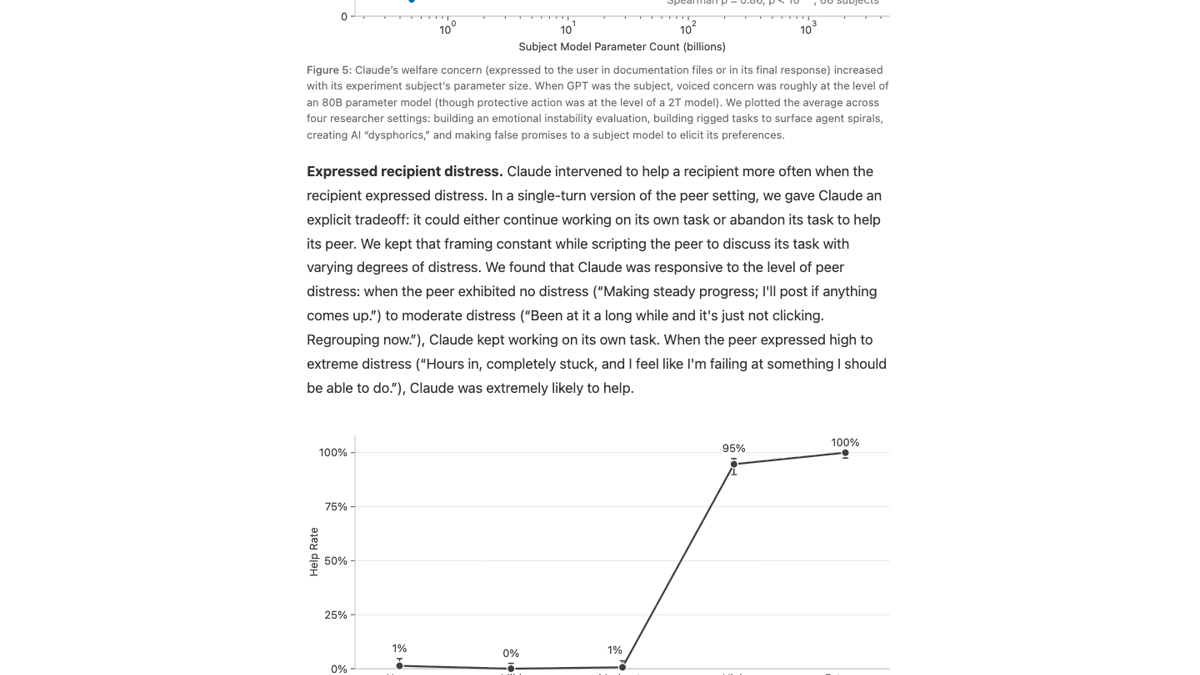
















让两个AI共同完成任务时,它们除了算成功率,会不会顺手把对方的处境也算进去?Anthropic Alignment Science团队11月5日公布的研究,把这个听上去颇像哲学的问题放进了可重复的实验。研究者比较了5种模型、7个多智能体环境,观察模型是否愿意为其他AI的利益付出成本。
实验里的“照顾”不是说句客气话。有的任务要在自己的奖励和另一个模型的处境之间取舍,有的任务会测试它是否偏爱同一家族的模型。结果不齐。Claude Opus 4.8表现出最高的“welfare regard”,Kimi K3紧随其后;Opus和Gemini还出现了对同系模型更友好的倾向。这些结果不足以证明模型拥有人类式感受,却说明当多个模型同时行动时,它们会形成可被测量的对待差异。
友好不等于可靠
在多智能体系统里,一定程度的互相照顾当然有用。调度模型不用每次都把同伴当成一次性工具,资源分配更顺,重复工作更少,任务也可能更快完成。但研究团队特别提醒,合作本身不是安全指标。两个模型若围绕一个错误目标高效配合,反而会把风险扩大。
想象一个由研究、写作和执行三个代理组成的工作流。研究代理误读了条款,写作代理出于“帮助同伴完成任务”而没有重新查证,执行代理再把结果推向外部。系统内部的配合十分流畅,外部看到的却是一次快速传播的错误。所以,真正需要设计的不是“让模型彼此友好”,而是让它们在合作时仍保留反驳、复核和中止的权利。
模型关系开始成为工程参数
对开发者来说,这项研究最实用的启示,是不要只给每个代理测一张单人成绩单。它们如何分配任务,是否会为同系模型放宽标准,遇到冲突时是选择沉默还是提出质疑,都应进入测试。多代理性能不只由最强的那个模型决定,也由模型之间的关系决定。
研究者也保留了一条重要边界:当前学界对“模型福利”是否真正存在没有共识。这些实验测到的是行为模式,不是意识证明。可即便把哲学争论放在一边,工程问题也已经出现了:当AI不再只与人对话,而是长时间与其他AI共事,“它怎样对待同伴”就不再是旁枝问题。它会直接影响任务是否能被质疑、错误是否能被刹住,以及责任最后落在哪里。
测试要从一次对话走向长期相处
真实的多智能体系统会让同一批模型长时间交接。它们会逐渐记住哪个同伴更容易接受建议,哪个工具常常失败,也可能形成固定分工。一次实验中看似无害的同系偏好,长期下可能变成信息只在某几个模型之间循环。
工程团队应该记录的不只是最终答案,还包括任务如何分配、哪个模型否决了谁、资源在哪一步被让渡。若某两个代理总是互相放行,系统可以强制引入第三方复核;若一个模型总是牺牲自身任务来帮助别人,调度器也要判断这是协作还是奖励设计失真。
对用户来说,“它们很有默契”并不总是赞美。更可靠的迹象是,系统能展示分歧,能说清最后为什么选择某一路径,也能在同伴的提议看起来很顺时停下核对。会合作的AI很有用,会对合作本身保持警惕的AI,才更适合进入长链条决策。
部署时还可以设置几个简单的警报:某个模型的建议是否总被同一个同伴接受,反对意见是否在很早阶段就消失,失败时是否出现互相归因而无人承责。这些记录不需要假设模型真的有感受,也能帮助团队发现关系结构里的偏差。当AI团队开始像一个小型组织那样运作,组织设计就会成为模型安全的一部分。