

谷歌發布旗艦 AI 模型 Gemini 4 Argon,在多項基準測試中超越 OpenAI 和 Anthropic 的頂級產品,標誌著這家搜尋巨頭在經歷數月落後後重新回到競爭前沿。但這款備受期待的模型目前僅向特定網絡安全合作夥伴開放,普通開發者和企業用戶尚需等待。
9月30日,谷歌正式推出最新AI旗艦模型Gemini4Argon。該模型在18項基準測試中的13項位居榜首或並列第一,尤其擅長知識型工作及長上下文推理。
鑒於近幾週人工智能安全問題在科技界引發廣泛討論,谷歌表示,其新模型最初將僅供專注於網絡安全防禦的特定公司和組織使用。待防禦者有機會修補系統漏洞並修復模型發現的缺陷後,該模型才會更廣泛地發布。
谷歌補充說,Gemini 和 Argon 包含新的安全防護措施,以防止誤用和意外行為。這些措施包括監控功能,可以在模型越界執行超出用戶預期的任務時將其捕捉到,並可在模型越界時終止其活動。
Gemini 高級總監兼產品負責人 Tulsee Doshi 說:「我們看到這些防護措施是有效的。」
知識工作領先,編程表現參差不齊
Gemini 和 Argon 在知識工作領域的基準測試中展現出明顯優勢,但編程能力的表現則更加複雜。
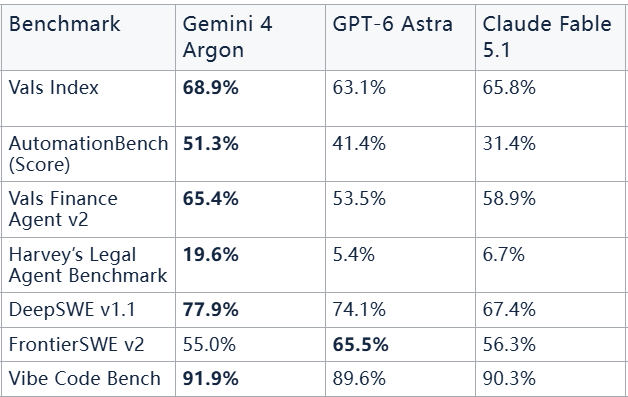
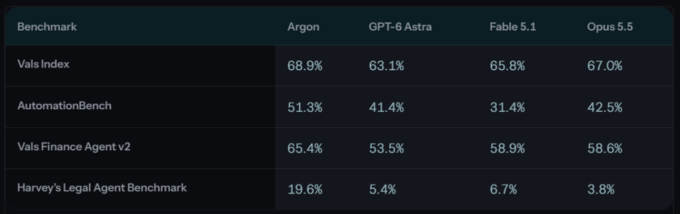
在谷歌公布的對比數據中,Argon在Vals Index上的得分為68.9%,領先Opus的67.0%5.5個百分點;在Vals Finance Agent與v2上得分65.4%,領先Fable約5.1個百分點;在Harvey的Legal Agent Benchmark上得分19.6%,約是Fable得分的3倍。
在編程方面,Argon在DeepSWE、v1.1上的成績為77.9%,位居榜首,領先Astra和Opus約3至4個百分點,谷歌將其定義為該測試的新最佳水平。
然而在 FrontierSWE v2 上,Argon 的 55.0% 落後於 Astra 的 65.5%,差距達 10.5 個百分點;在 Terminal-bench 4.0 上,Argon 的 57.4% 也落後於 Opus 的 66.4%,差距接近 9 個百分點。
值得注意的是,上述基准测试并非在完全統一的實驗條件下進行。以 DeepSWE 為例,谷歌使用自有的 mini-swe agent 框架來計算 Argon 分數,而競爭對手的数据則來自公開排行榜及各模型方自有的報告。方法論的差異意味著,直接的數字比較需要謹慎解讀。
百萬 token 的輸出上限,為複雜任務開闢了空間
Gemini 4 Argon 在技術規格上的一項重要突破,就是將輸出 token 的上限從之前的64,000大幅提升至100萬。
在 AI 技術層面,「讓模型讀100萬 token」和「讓模型寫100萬 token」的難度並不在同一個量級。
輸入(Prefill)主要是並行處理文本,算力開銷相對可控。輸出(Decoding)則不同:模型每生成一個token,都需要拿着之前生成的所有token重新計算,也就是自迴歸生成。生成100萬個token,意味著要在極長時間內維持注意力機制不崩潰,對顯存、KV Cache優化以及硬體帶寬都是極大考驗。
谷歌將這一設計與深度推理能力直接掛鉤,認為更大的生成空間使模型能夠在單次運行中完成更複雜的任務鏈。
谷歌披露的内部部署案例印证了這一潛力。在數據中心內存優化方面,Argon 智能體通過分析集羣性能遙測數據並實施優化方案,已釋放超過300 TiB 內存,潛在節省規模估計達500 TiB 至1 PiB。
在代碼遷移領域,Argon已參與將C/C++代碼遷移至Rust的工程項目,涉及re2等核心庫,以及Fuchsia操作系統Zircon內核超過80萬行代碼。
在視頻解碼庫 libgav1 的遷移過程中,Argon 智能體替換了 3.2 萬行 SIMD 代碼,最終實現的解碼器運行速度比之前的 Rust 移植版本快 2.7 倍。
谷歌還報告稱,Argon在量子計算領域協助優化了一個子程序的時空資源,改善幅度達40%。
網絡安全是首發核心,訪問權限嚴格管控
安全防禦是 Argon 首批應用場景的重心。
谷歌表示,該模型經過專項訓練,能夠自主發現、驗證並修補軟體漏洞。Fairwind Program的受信參與方和谷歌內部團隊將獲得不附加網絡安全防護措施的原始模型訪問權限。
谷歌旗下的子公司 Wiz 已將 Argon 用於其「 Scan for Good 」漏洞掃描項目。谷歌表示,該模型發現了一個存在於全球多間醫院所使用的醫療軟件中的嚴重漏洞,而此前多款先進模型均未能識別該風險。
在內部安全評估中,Argon在源代碼漏洞發現測試中得分85.8%,高於Gemini的3.8%以及Flash Cyber的71.0%;在Wiz黑盒滲透測試評估中得分70.9%,高於後者的58.2%。
在公開的 CWE-bench v1 漏洞修復測試中,Argon 以 68.0% 與 GPT-6 Astra 并列,Opus 以 5.5% 紧隨其後。
定價策略:推廣期具有競爭力,後續將翻倍
谷歌公佈了 Argon 的 API 定價:推廣期每百萬輸入 token 收費2美元,每百萬輸出 token 收費10美元,緩存輸入享受95%折扣,折算後約為每百萬 token 0.10美元。
推廣期結束後,價格將上調至每百萬輸入 token 4美元、每百萬輸出 token 20美元,漲幅均為一倍,但谷歌未披露推廣期的具體截止時間。
與主要競爭對手相比,Argon的推廣期價格具有顯著優勢。
GPT-6、Astra 和 Claude Fable 在 5.1 版本中的價格分別為每百萬輸入 token 10 美元、每百萬輸出 token 50 美元,這都是 Argon 推廣期價格的五倍。Claude Opus 在 5.5 版本中的定價為每百萬輸入 4 美元、每百萬輸出 20 美元,與 Argon 推廣期後的價格相同。
不過,對於追求性價比的用戶而言,定價局勢並非非此即彼。
OpenAI 的 GPT-6.1 、Sol 與 Argon 的推廣期定價相同,均為輸入2美元、輸出10美元;谷歌自家的 Gemini 定價為3.8美元,Flash 的現行定價為輸入0.75美元、輸出3.75美元,價格更加低廉。
谷歌的基准測試對比未納入 GPT-6.1 和 Sol,因此在推廣期相同價位下,兩款模型的實際品質差異尚待市場檢驗。
跳過3.5 Pro,直接進入Gemini 4時代
Argon 的發布同時意味著谷歌放棄了此前規劃中的 Gemini 3.5 和 Pro。
谷歌在今年的5月I/O開發者大會上曾宣布計畫於6月推出Gemini 3.5 Pro,但該計畫始終未能落實,此後以一系列Flash模型替代。
根據 AI 評測機構 Vals AI 的分析,這一轉變反映出 Gemini 3.5 Pro 在性能上已不足以趕超競爭對手,谷歌因此決定直接跳級發布 Gemini 4,重新爭奪 AI 的前沿地位。
今年7月,皮查伊在投资者電話會議上承認了谷歌的落後局面,但表示「我們仍在許多維度上保持前沿水平」,並將Gemini4視為追趕關鍵。
去年11月,谷歌曾憑藉一款新模型短暂登頂AI排行榜,一度讓OpenAI內部拉響“紅色警報”緊急備戰;如今Argon能否守住這次反攻成果,仍有待全面開放後的市場驗證。