IT之家 11月4日消息,小鵬集團聯合北京大學、香港大學等高校研究團隊發布了具身感知基座模型研究成果 GroundingPI。
官方表示,這項研究提出了「感知優先」的技術路線,以約40億參數規模,在34項公開感知基準的綜合評測中位列第一,並在機器人仿真任務中展現出更高的數據處理效率與更強的場景泛化能力。
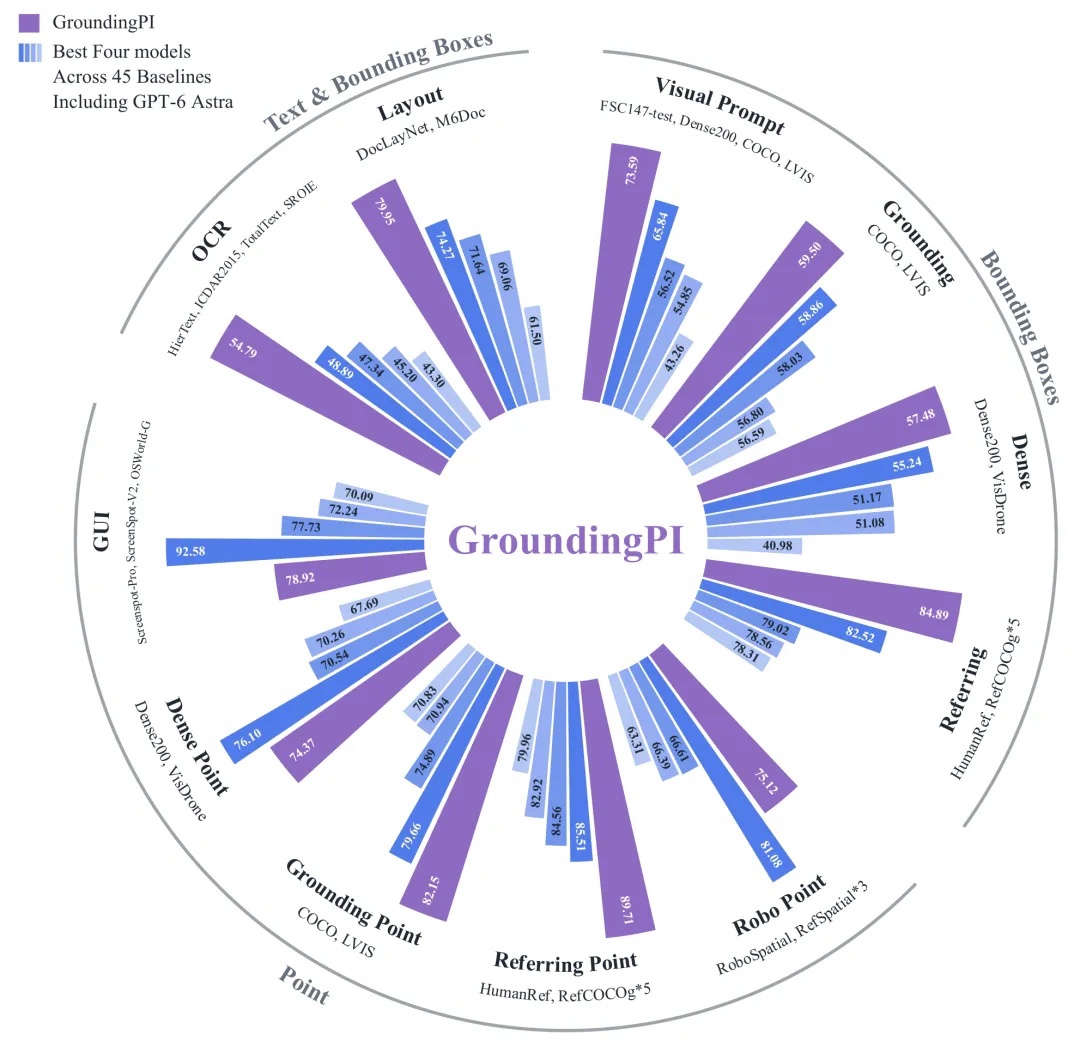
研究團隊將 GroundingPI、OpenAI、前沿模型 GPT-6 和 Astra 在同一套 34 項感知基準上進行對比。按照 11 类能力的等權平均,GroundingPI 得分 73.68,Astra 得分 71.54。
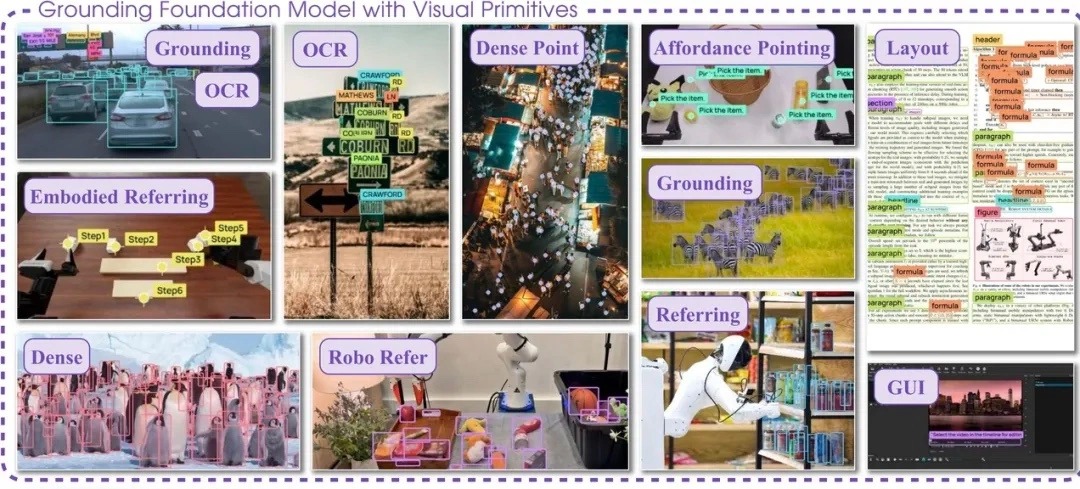
據介紹,GroundingPI提出,具身智能的首要前提是精確感知自身與周邊物體的空間位置,這種感知對於物理AI至關重要。如果模型無法準確定位目標在畫面中的位置,無論學習多少動作知識也無法有效落實。
基於這一判斷,GroundingPI 在訓練階段不使用帶有關節動作標籤的機器人數據,而是全部採用無動作標籤的純感知數據,涵蓋通用檢測、密集小目標、指代定位、文字識別、文檔版面、界面元素、機器人空間定位等 11 種感知能力,目標是讓模型首先理解「物體是什麼、在畫面的哪個位置」。
項目名稱也源於此,Grounding 對應於視覺定位這一核心感知能力,PI 是 Physical Intelligence(物理智能)的縮寫。
官方表示,該研究目前處於科研原型階段,但其實驗設計已經指明在具身領域的落地方向,目前仿真結果也直面量化部署中的兩個核心問題。
第一,大幅降低示教成本。機器人完成每一項新任務通常需要人工收集成千上萬條示教數據。以 GroundingPI 為視覺基底的系統而言,僅使用 50% 的示教數據即可超越對比模型使用 75% 數據時的成功率。其機制在於,它直接承擔了傳統 VLA 模型中「物體在哪裡」的學習工作。這意味著在實際部署中,在相同的成功率目標下,所需的人工示教量能夠大幅降低。
第二,帶來更強的場景泛化性。目前機器人落地的一個痛點是,切換到另一個空間、換另一個物體之後,之前已經會做的事情就不再會做了。而 GroundingPI 所具備的感知能力,可以讓機器人在應對材質變化、物體品類變化、容器變化、背景變化等不同現場變量時,都能保持較強的穩定性,不會因環境變化而影響執行性能。在仿真環境的散料分揀、料箱清點等高密度場景中,GroundingPI 的系統能夠分類抓取同類工件,快速應對物品形態。這也為「一套權重跨工位複用」提供了實驗支撐。
IT之家附相关链接:
- 網站: https :// groundingpi.github.io /
- 論文:https :// arxiv.org / abs /2609.39601
- __BJW_BOLOKA_00001__ : __BJW_BOLOKA_00002__ :// _BJW_BOLOKA_00003__ / _BJW_BOLOKA_00005__
- __BJW_BOLOKA_00001__ : __BJW_BOLOKA_00002__ / _BJW_BOLOKA_00004__ / _BJW_BOLOKA_00005_