IT之家 11月5日消息,輝達於當地時間11月4日正式發布最新的CUDA Toolkit 13.5,為下一代AI計算平臺Vera Rubin提供正式可用的(GA)支持,標誌著相關架構從早期開發者預覽階段進入面向企業生產環境的部署階段。
據輝達官方介紹,此次更新不僅完善了 Vera Rubin 平臺的底层軟件支持,還針對 GPU 資源調度、多 GPU 通信、數學計算庫及性能分析工具進行了多項升級,重點面向大規模 AI 變量訓練和推理場景。
在計算性能方面,CUDA 13.5 更新了 cuBLAS 的矩陣乘法啟發式策略和內核調優機制,針對 Vera Rubin 架構上的 NVFP4、MXFP8 低精度矩陣運算進行了優化,覆蓋混合專家模型(MoE)等訓練場景。輝達表示,這些改進能在無需針對每種計算形狀單獨進行自動調優的情況下,提高訓練和推理吞吐量。
在 GPU 调度方面,CUDA 对 NVIDIA 的多進程服務(MPS)進行了升級,新增加了加權時間片機制。管理員可以為運行重負載的 MPS 伺服器設定更長的基礎計算時間片,同時獨立調整 GPU 在不同任務之間的切換頻率,從而更靈活地控制多任務環境下的資源分配。
還加入了流式多處理器(SM)分區負載均衡功能。任務可以在資源充足時借用其他分區暫時閒置的SM資源,而當原分區需要使用這些資源時,系統會先回收已借出的部分。無論資源如何動態流轉,應用看到的基礎分區規模始终保持穩定。此外,新版本還增加了基於Linux、cgroup的資源路由和命名空間級SM分區配置。
局部域(Locality Domain)也獲得了新的資源劃分策略。應用現在可以選擇兩種SM分區方式:一種是在各局部域中分配相同數量的SM,以保證資源規模的一致性和可預測性;另一種則將原本處於分區之外的補充SM納入計算分區,盡可能利用GPU的全部計算資源。開發者還可以通過相關API查詢各分區實際獲得的SM數量,以便合理分配計算任務。
多 GPU 通訊能力是此次更新的另一項重點。 CUDA Tile 現在支持在計算核心內部直接存取其他 GPU 的顯存,相關功能依賴於 NVLink 高速互連來實現。藉助多播指針和專用的多 GPU 内存操作,開發者還可以在支持 NVLink SHARP 的 NVSwitch 網絡中執行跨 GPU 的數據歸約和寫入操作。
這意味著開發者能夠將 GPU 之間的數據通信與計算操作融合在同一个核心中執行,從而減少傳統多卡協同過程中由於核心邊界和數據傳遞所產生的額外開銷。輝達列出的適用場景包括融合矩陣乘法以及跨 GPU 的數據歸約。
Mabapi le sethala sa Windows, NVIDIA e fetotse ka tlhamalalo selekanyo sa tshegetso ya sekao sa mokgweetsi sa Rubin kago. Go simolola ka thulaganyo ya CUDA, CUDA ga e tlhole e tshegetsa mokgwa wa Tesla Compute Cluster (TCC), mme e tshegetsa fela __EP_0_KE_2. (__BJW_BOLOKA_00009__) le __BJW_BOLOKA_00003__ (__BJW_BOLOKA_00010__). Gareng ga tsone, MCDM ke sekao sa mokgweetsi sa ditiragalo tse di phepa tsa dikhomphiutha, mme ditiriso tse di amanang le tsone le didirisiwa tsa go tsenngwa tirisong di tlhoka go fetolelwa go tsamaisana le bogolo jo bosha jwa tshegetso.
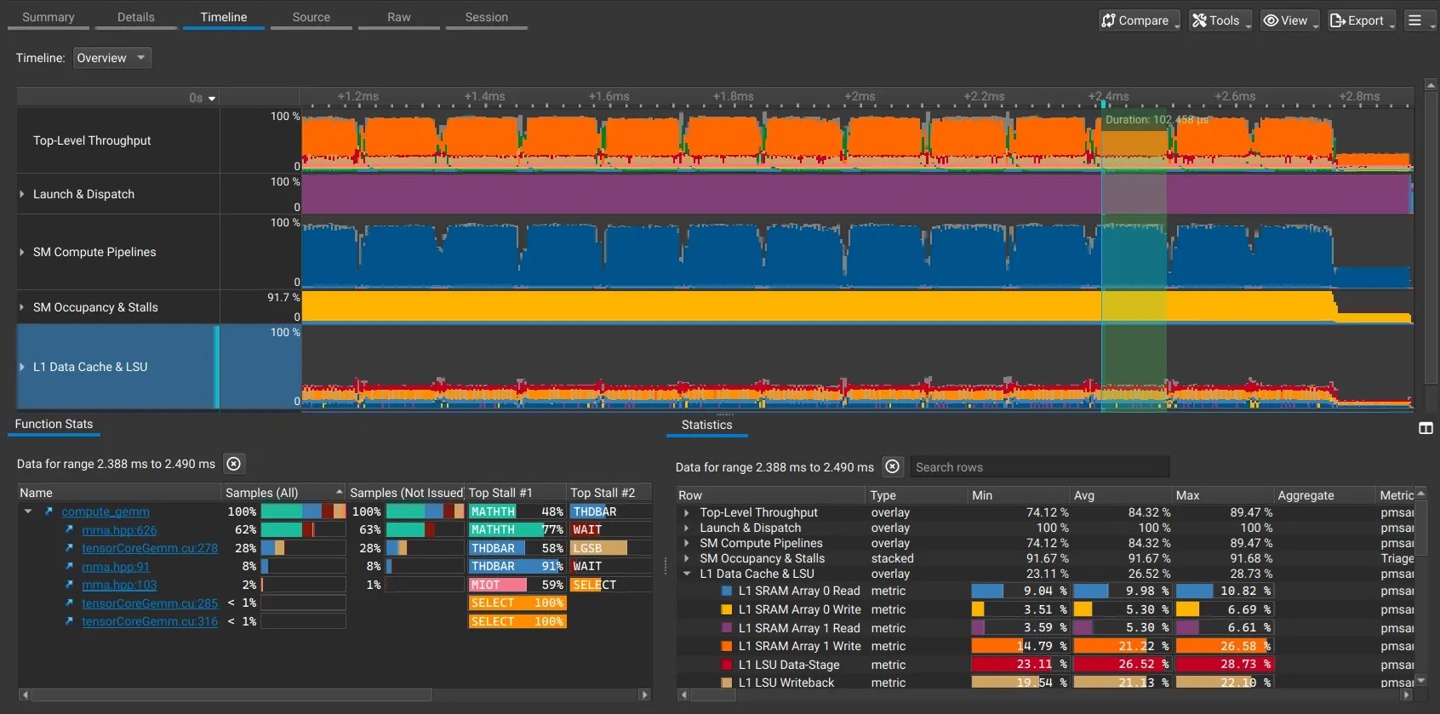
在開發工具方面,CUDA 13.5 首次以公開預覽的形式推出了 NVIDIA Nsight Perf SDK、for、AI,為長時間運行的 AI 變量與推理任務提供了持續性的性能分析能力。該工具能夠不斷收集 GPU、CPU 的性能指標及執行上下文,幫助開發者定位難以復現的間歇性性能問題,並支持通過 Perfetto 查看收集結果。
此外,CUDA 13.5還更新了CUDA Python、CUDA Graph、CCCL 3.5等組件。其中,CUDA Python 1.2增加了批量內存複製、程序化依賴啟動(PDL)以及更靈活的CUDA Graph更新能力;CCCL 3.5則加入了面向CUB的公開調優接口、批量Top-K選擇和可重複浮點掃描等功能。
在驅動方面,輝達同步發布了R620系列數據中心GPU驅動,其中Linux版本為620.70.06,Windows版本為621.14,發布日期均為11月4日。IT提醒,CUDA Toolkit 13.5與數據中心驅動將分別發布,驅動將不再作爲Toolkit的內置組件提供。
相關閱讀:
- 《輝達回應Vera Rubin平台規格變更:新版為量產規格,第三方跑分均是按量產版測的》
- 《輝達發布 Game Ready 621.14 驅動:優化〈魔獸世界:無限〉,修復視頻黑屏問題》