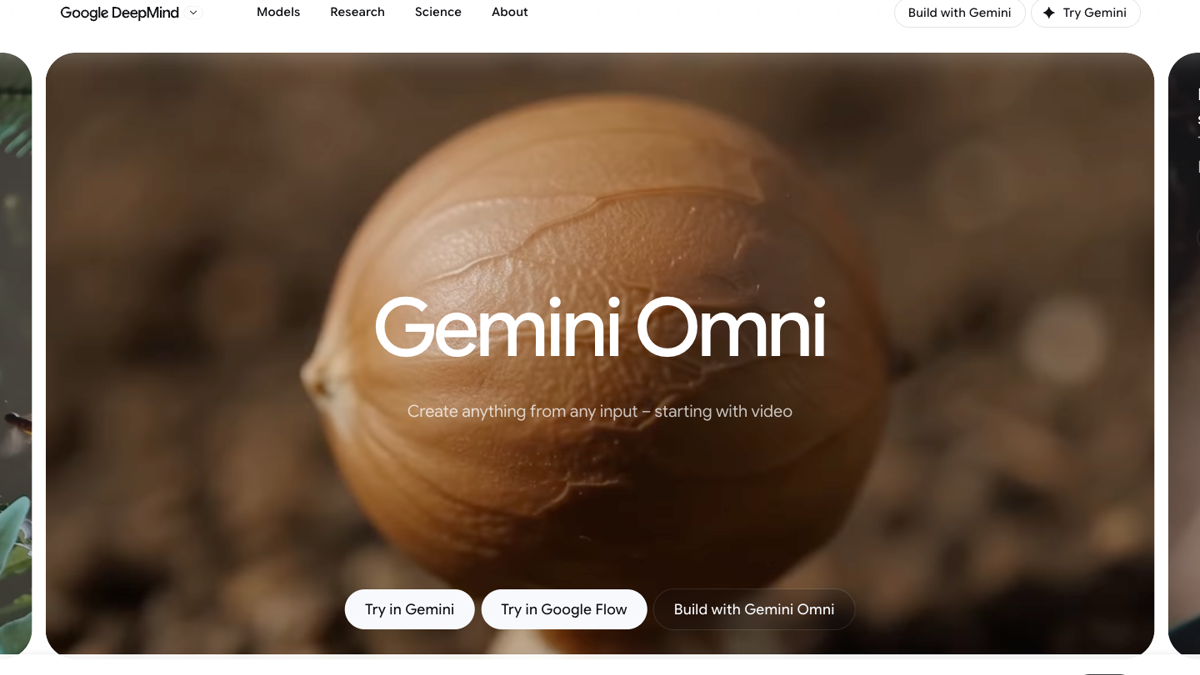
將一段自拍視頻交給模型,然後說「鏡面像液體一樣起波紋」、「把人物變成木偶」、「保留原來的房間和動作」,過去需要剪輯師在時間軸上逐層完成的工作,如今可以像修改文案一樣連續詢問。Google DeepMind 在11月5日發布 Gemini Omni 1.2 Flash 模型卡,將這款模型描述為能從文字、圖像、音頻和視頻輸入生成帶聲音的高解析度視頻,並支持通過自然對話反複編輯。視頻製作的入口正在從軟件面板移動到語言,但這也讓編輯痕跡、人物授權和事實可信度更難被肉眼識別。
對話編輯真正省下了什麼
傳統的影片製作方式通常是「一次提示、一次結果」。如果創作者想要改變人物的動作、光線或鏡頭,往往需要重新製作,之前的版本中的人物和場景也可能会產生變化。Gemini Omni 強調連續編輯:每次修改都是建立在上一次的結果之上,盡量保持場景的連貫性。這種機制將複雜的操作分解成一系列可以理解的步驟,創作者不必先學習蒙版、關鍵帧和合成节点,就能逐步達到目標。
模型卡列出的輸入包含文字、圖片、音頻和視頻,輸出則是帶有音頻的視頻。產品頁面進一步展示了如何利用參考素材來改變畫面風格、重寫動作以及補充聲音的案例。這樣不僅能縮短製作時間,還能降低表達成本。一位導演可以先描述「人物觸碰到鏡子」,再補充材質、音效和鏡頭節奏,而不需要一次性寫下長到難以控制的提示詞。
速度版模型所瞄准的並不是一部電影
“Flash”意味著產品更關注速度和成本。廣告團隊、短視頻創作者、遊戲工作室和教學內容製作方通常需要快速測試多個版本:同一素材換比例、換語言、換節奏,再根據反饋繼續修改。若模型能在較短時間內維持角色、對白和動作的一致性,最先被改變的將是高頻迭代,而不是一次性的大制作。
這也會重新安排團隊的分工。過去由執行人員完成的大量格式調整和初步合成,可能會先交給模型處理;人們將把時間放在選擇鏡頭、控制節奏、核實事實和處理版權上。創意崗位不會因為按鈕變少而自動消失,但「會操作某款軟件」所帶來的優勢會變弱,理解敘事、審美和受眾價值的重要性則會上升。
能改聲音的人物,風險比換背景更大
DeepMind在模型卡中特別提到,視頻編輯能力可以改變人物說話內容,目前對此進行限制,並繼續研究如何安全開放。這句話非常關鍵。更換天空顏色和讓一個真實人物說出從來沒有說過的話,不是同一种風險。後者可能涉及名譽、詐騙、政治傳播和證據汙染,而且生成質量越高,普通用戶越難憑直覺判斷。
Google 表示系統在訓練前與訓練後採用的安全措施,並通過 SynthID 在 AI 內容中加入水印。水印能為平台核驗提供線索,但它並非萬能證據:視頻經過裁剪、轉碼或二次拍攝後,識別能力可能會受到影響;不支持驗證的應用也不會自動提醒觀眾。真正有效的治理還需要來源記錄、人物授權、平台標註和濫用投訴機制共同作用。
模型卡也暴露了信息空白
這份模型卡沒有給出完整的訓練數據清單,而是將若干內容指向基礎模型 Gemini Omni Flash;已知的限制部分也主要引用基礎模型資料。對於一般創作者來說,這不會影響試用;但對於企業法務、媒體和教育機構而言,卻意味着仍需自己解答數據許可、地區開放、人物肖像和輸出責任等問題。
模型卡同時說明,Omni 1.2、Flash 并未被認為能帶來相對於 Gemini 3.1、Pro 或 3.7、Flash 的實質性前沿能力躍升,因此沿用相關安全評估。這是風險分類上的判斷,並不等於每個視頻編輯場景都已經得到驗證。能夠大規模修改聲音和畫面的產品,其社會風險更多來自於可獲得性、速度與傳播,而不仅仅來自於模型是否達到某個前沿能力等級。
視頻軟體正變成意圖系統
未來的視頻工具可能不再要求用戶從素材箱、軌道和濾鏡開始,而是會先問「你希望觀眾看到什麼」。模型再將這一句自然語言翻譯成鏡頭、音軌和效果。這樣的入口會讓更多人擁有表達能力,也會讓成片數量暴增。稀缺資源隨之從製作技巧轉向可信來源、獨特素材和可辨認的作者責任。
Gemini Omni 1.2 Flash 最值得關注的,不是它能生成多美麗的畫面,而是編輯動作正從手工操作變成可對話、可連續調用的服務。當創作門檻下降時,平台和創作者必須同時提高證明門檻:這是誰的面孔、誰的聲音、哪些部分經過修改、觀眾如何驗證。否則,最方便的編輯工具也有可能成為最便宜的偽造工具。