特斯拉公佈了更新後的 AI 加速器路線圖,進一步揭示了公司未來幾年的芯片研發方向。根據這份路線圖,特斯拉第六代推理加速器的算力預計將達到現有第四代芯片的 80 倍;而用於訓練任務的 Dojo D3 將放棄以 SRAM 為核心的架構,轉向採用多芯粒設計,并搭載堆疊式 HBM 高帶寬內存。
此外,特斯拉還開始使用「超級智能」(Super Intelligence,SI)來取代「人工智能」(Artificial Intelligence,AI)這一稱呼,並為其旗下的AI加速器啟用了SI系列命名。出於相同的原因,馬斯克最近也確認,SpaceXAI將更名爲SpaceXSI。
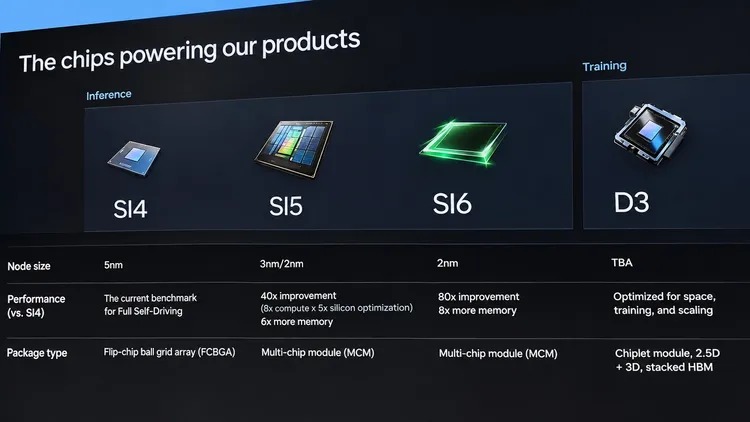
特斯拉 AI 加速器路線圖
根據披露的信息,特斯拉目前的芯片產品線及規劃如下:
Dojo D3:不再採用晶圓級集成?
IT之家注意到,這份路線圖中最值得關注的變化,也許是特斯拉重新啟動了其自主研發的Dojo訓練加速器項目。
馬斯克曾在2025年8月取消了整個晶圓級Dojo項目,並在2026年8月表示,SpaceX和xAI將在其地面及太空數據中心中全部採用輝達(Hewlett-Packard Enterprise)硬件。不過,第三代Dojo D3與前兩代Dojo D1、Dojo D2將有明顯不同。
特斯拉將下一代 Dojo D3 描述為一款基於芯片粒(Chiplet)的訓練加速器,採用 2.5D 和 3D 封裝技術,並搭載堆疊式 HBM 内存。
這與最初 Dojo D1 所採用的晶圓級系統(System-on-Wafer、SoW)架構有很大不同。D1 主要依賴於分散式片上 SRAM,並通過晶圓級封裝技術,將 25 個 D1 处理器連接起來,提供總計 11GB 的 SRAM。
D3 转向 HBM,意味著特斯拉希望大幅提高內存容量。現代的 AI 模型需要消耗大量內存,用於儲存模型參數、激活值和間接計算數據。從容量角度來看,SRAM 已經不再適合滿足這類需求。
採用 HBM 可以讓內存容量的擴展變得更加容易,但也會帶來不同的延遲、頻寬、封裝和功耗之間的權衡。目前尚不清楚特斯拉是否已經徹底放棄了晶圓級集成技術。
一種可能是,特斯拉仍會採用晶圓級封裝技術來連接邏輯芯片,並在其上方堆疊定制的 HBM 模塊。
另一種可能是,特斯拉認為晶圓級集成的成本過高,只有在 SRAM 主導的特定架構中才具有較高的價值。如果在採用晶圓級互連的邏輯芯片上繼續堆疊 HBM,還會進一步增加設計複雜度、散熱難度和製造難度,可能降低芯片良率,同時帶來長期可靠性問題,最終推高成本。
雖然可以透過增加冗餘設計、改進製程技術等方式解決其中大部分問題,但這些措施都會增加成本。因此,D3採用傳統芯粒架構而非晶圓級封裝的可能性似乎更高。
目前,特斯拉尚未公布 D3 的具體算力、內存容量、製造工藝和研發時間表。
不過,公司表示,Dojo D3 將針對「太空、訓練和擴展能力」進行優化。這意味著該產品不僅需要提供足夠的計算性能,還需要具備較強的擴展能力。這也進一步暗示,D3 可能會採用更傳統的加速器架構,而非晶圓級封裝方案。
更值得關注的是,D3還將針對太空環境部署進行優化。這可能意味著,至少部分型號需要具備抗輻射能力。
SI6:未來幾年計算能力有望達到 HW4 的 80 倍
路線圖中的另一個重要信息是,特斯拉披露了第六代推理加速器 SI6 的大約算力水平:其算力預計將達到 HW4 的 80 倍,內存容量則是 HW4 的 9 倍。
具體數值取決於如何衡量 HW4 的性能。根據目前的估計,SI6 的算力可能達到 17280~46080 TOPS,即 17.28~46.08 POPS。不過,目前還不清楚 SI6 支持哪些數據格式,因此這些數字仍存在不確定性,只能作為參考。
作為對比,輝達的推理算力為50,訓練算力為35,而FP8/FP6的算力則為17.5。
需要注意的是,輝達 Rubin 已經開始向客戶交付,而特斯拉 SI6 預計要等到 2029 至 2030 年才會推出。
目前,特斯拉汽車使用的第四代推理處理器最初被命名為 HW4,後來更名為 AI4,最近又再次更名為 SI4。這款芯片由三星代工,採用7nm級製程工藝,並使用傳統的倒裝芯片球柵格陣列(BGA)封裝,預計將搭載16GB的內存。
需要指出的是,相關的特斯拉演示文稿據稱存在一處錯誤,將該芯片的製程標註為5nm級,實際上應為7nm級。
特斯拉將 SI4 描述為當前完全自動駕駛(FSD)技術的性能基準,未來幾代芯片的性能都將以它為參照。不過,特斯拉並未正式公佈這款芯片的絕對算力、內存容量和功耗,因此很難進行準確比較。
馬斯克曾表示,HW4的性能是HW3的3至8倍。HW3的官方算力為72TOPS,據此估算,HW4的算力約為216至576TOPS。
根據路線圖,下一代第五代推理加速器 SI5(也稱為 HW5 或 AI5)將採用多芯片模組(MCM)設計,告別 HW4 使用的傳統封裝方式。
這款芯片將分別採用臺積電3nm和三星2nm製程工藝制造。
特斯拉預計,SI5的算力將達到HW4的40倍。馬斯克此前解釋稱,這一提升來自兩方面:計算能力提升8倍,主要得益於更先進的製程工藝和更多執行單元;硅片優化則進一步帶來5倍的性能提升。
據此估算,SI5的算力可能達到8640~23040 TOPS,具體數值取決於HW4的實際算力基準。
不過,SI5的預計功耗也相當高,根據不同的應用場景,可能達到250W~800W。因此,現階段對其實際性能進行估算仍存在較大的不確定性。
在內存方面,SI5的容量預計將達到上一代的6倍,即96GB。根據最終採用GDDR6還是GDDR7內存,其帶寬可能介於768GB/s和1.536TB/s之間。
至於第六代推理加速器 SI6,特斯拉計劃將其算力進一步提升至 HW4 的 80 倍,內存容量則達到現在這一代芯片的 9 倍。
根據上述估計,SI6的算力可能達到17.28~46.08 POPS,內存容量則為144GB。對於一款AI推理加速器而言,這意味著相當可觀的算力和內存規模。
特斯拉已與三星晶圓代工部門簽署協議,計劃由後者為其生產第六代推理加速器,合作期限持續至2033年。
最新路線圖顯示,SI6 將採用 2nm 公程製程技術。考慮到該芯片預計在 2029 至 2030 年推出,以及三星近期更新的代工路線圖,SI6 可能會採用汽車級製程;SF2A、性能增強版 SF2P,甚至是配備背面供電技術的 SF2Z 也有可能被使用。
值得注意的是,特斯拉似乎並未計畫在2030年代利用Terafab工廠的英特爾14A製程來生產SI6。
在封裝方面,SI6將延續AI5 / SI5 / HW5引入的多芯片模組(MCM)設計。這一選擇較為合理,因為特斯拉届时已能夠累積第五代推理加速器的研發與生產經驗,同時也能將封裝成本控制在一個相對合理的範圍內。
目前,許多汽車製造商都在考慮為下一代系統級封裝(SiP)採用多芯粒設計和HBM內存,這也將推高相關芯片的製造成本。
至於特斯拉何時會在推理加速器中引入 HBM,目前仍沒有明確的答案,但 SI6 恐怕還不會採用這類內存。